22 个部分 · 4 个检查点 · 免费 3 部分 / 会员 19 部分 →
Shopify 技术 SEO:页面为什么没进搜索
商品页能打开,却没有出现在 Google 搜索里时,先检查它是否可访问、允许抓取、没有误加 noindex,再看索引记录里的主版本。 技术 SEO 用可复查证据定位阻塞 ;它不能保证页面收录或排名。本课适合要排查 Shopify 集合、产品和指南页的店主或内容负责人,练习会留下一个能交给负责人复查的 URL 记录。
要点 先固定同一条 URL
用户能打开、Google 当前能抓取、URL 已进入索引,是三个不同状态。把它们分开记录,才知道下一步要查访问、抓取、索引还是主版本。目录规模越大,越要从承接真实搜索任务的核心 URL 抽查,而不是先修完工具列出的所有 warning。
选择依据也要分开:自己能打开页面,只能说明当前浏览器这次访问成功;仍要单独检查登录限制、响应内容和 Google 的访问状态;抓取规则回答爬虫能否请求;noindex 表达不希望进入索引;canonical 表达相似页面中偏好的主版本;重定向把旧地址迁到相关新地址;sitemap 与站内链接帮助发现。 这些控制对象不同,任何一条都不保证收录或排名。
用一款通勤保温杯的商品页做练习例子(示例规格为 20oz,oz 在这里是容量单位“液体盎司”):容量、杯架适配和配送信息可能回答了购物问题,但误加 noindex 仍会妨碍搜索入口;反过来,移除 noindex 也不会补上缺少的产品信息。先写清页面用途,再检查技术状态,才能分辨内容缺口和设置阻塞。
先分清索引记录和实时测试
Search Console 的 URL Inspection 把已索引数据和实时测试分开:索引记录反映 Google 最近一次处理到的页面状态,可查看 Google 选择的 canonical;实时测试检查此刻是否能访问和读取。 实时测试不能预测 Google 最终会选哪个 canonical ,两种结果也不能互相替代。记录两边各自的时间和结果;若结果不同,先比较上次抓取、当前响应与声明来源,不要把时间差直接写成新故障。
再按控制对象判断:robots.txt 影响抓取请求,noindex 表达页面不进入索引的意图,canonical 提供相似 URL 的主版本信号,重定向把旧地址送往相关新地址,sitemap 帮助发现 URL。canonical 与重定向是较强信号,sitemap 是较弱信号;noindex 需要爬虫能读取页面。它们力度不同;有页面权限或信号冲突时,先记录证据,不要把任一项当成保证。
新设置生效后,仍可能要等待后续抓取和索引更新;一次实时测试通过不能证明已收录。遇到核心商品或集合受影响时,先保留改前文件、URL、状态码和回滚责任,再安排一项可复查的修改。
页面好了,索引记录为什么还是旧的
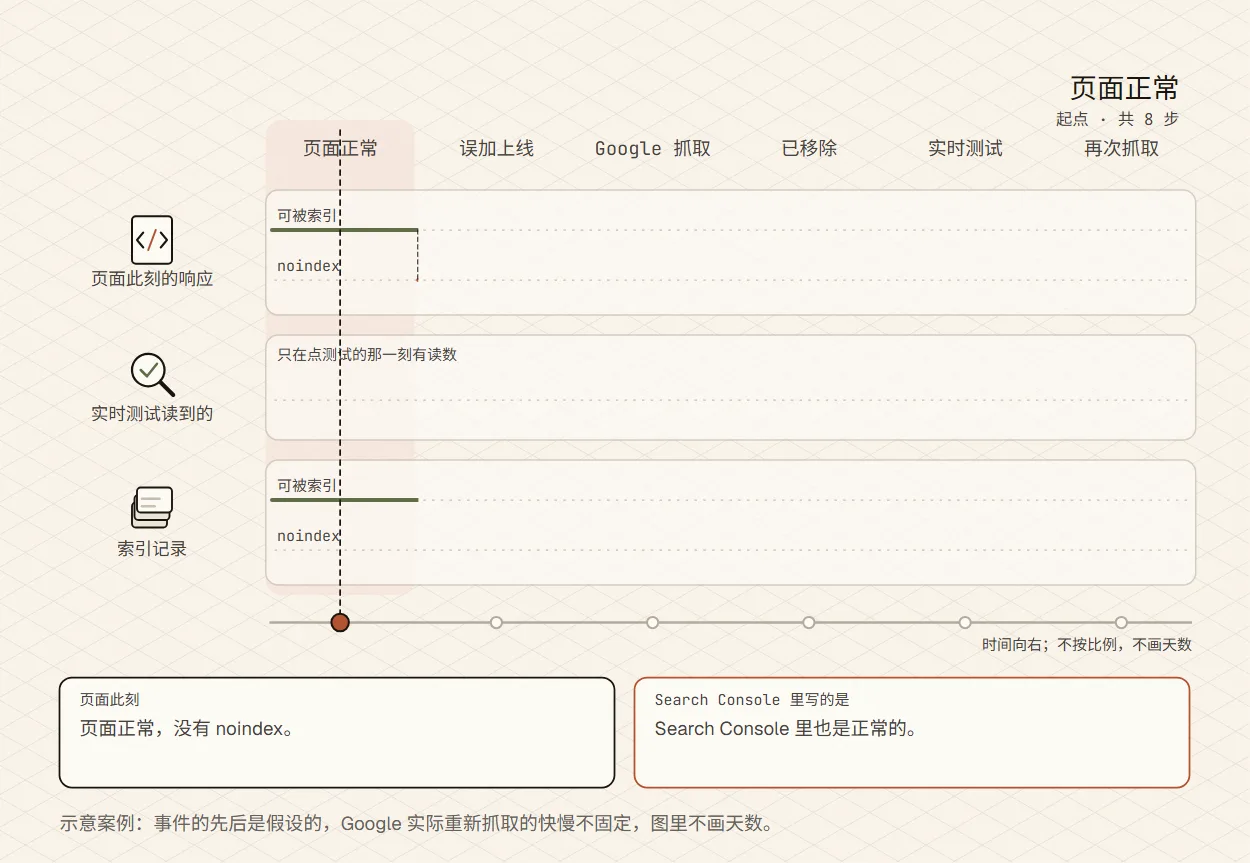
文字版:完整走一遍
- 误加 noindex 一次发布误给页面加了 noindex。页面此刻就是 noindex,Search Console 还什么都不知道。
- 记录写成 noindex Google 抓取了这一页,索引记录写成 noindex。从这一刻起,记录和页面是两份东西。
- 记录写成 noindex 实时测试读到 noindex,和记录一致:问题确认了。
- 记录写成 noindex 改之前先保存改前文件、URL 和状态码,并写下谁负责回滚。
- 已移除 noindex 移除 noindex。页面此刻已经正常,可是索引记录还没有变。
- 实时测试通过 实时测试通过:此刻页面能访问、能读取。这只说明现在,不说明已收录。
- 实时测试通过 比较上次抓取的时间和现在的响应:记录是改之前抓的,不是新故障。
- 记录已更新 等到下一次抓取,索引记录才更新。到这里才算真正好了。
示意案例:事件的先后是假设的,Google 实际重新抓取的快慢不固定,图里不画天数。
第一步先做什么?
自测未作答
免费注册可读 · 第 3-21 部分 · 19 个部分
会员内容:五类设置、URL 家族检查与可保存记录
把真实页面的状态、信号、负责人和复查条件放进一份本地记录。
这一部分包含
- 按 URL 家族逐条比较五种常见设置
- 留下访问、抓取、索引与主版本证据
- 导出可交接的检查记录与复查条件
注册免费,登录后就能读这一部分。
正在确认你的会员权限…
这一课还没有完成的检查点。可以从「直接动手」开始。
自测未作答
常见问题
- Shopify 技术 SEO 是什么,先检查什么?
技术 SEO 检查搜索引擎能否发现、请求和理解页面,以及页面有没有错误的收录或主版本信号。先选一个重要 URL,检查访问、源码、抓取和索引状态,再比对 sitemap、canonical 和内链。内容是否回答需求仍要另查;技术正常不保证排名。
- robots.txt 和 noindex 有什么区别?
robots.txt 控制爬虫能否请求某条路径;noindex 要求不把页面放入索引。被 robots 挡住的 URL 仍可能出现在搜索里,Google 也可能无法读取该页的 noindex。查看实际 HTML 或响应头,确认页面用途和适用规则后再改,不能把两者当作同一个开关。
继续阅读
技术阻塞排清以后,再判断内容和数据是否接得住。
继续检查同一页面的内容匹配与后续观察。Search Console、GA4 和订单各有口径,查询词不能拼成某个人到某笔订单的轨迹。
- 内容 SEO:检查页面是否真正回答需求: 技术设置通过以后,再看页面内容、搜索任务和商品事实是否匹配。
资料来源
这里只把官方技术文档转成新手阻塞分级,不承诺提交、修复或跑分后一定收录或排名。
资料 12 条最近核对
Google Canonical 文档 (在新标签页打开)核对于
支持什么
用于说明规范 URL 是主版本信号,需要和内链、sitemap、重定向配合。
Google robots.txt 文档 (在新标签页打开)核对于
支持什么
用于说明 robots 控制抓取,不是删除索引工具。
Google Sitemap 文档 (在新标签页打开)核对于
支持什么
用于说明 sitemap 帮助发现,但不保证收录或排名。
Google noindex 文档 (在新标签页打开)核对于
支持什么
用于说明 noindex 需要能被抓取读取,不能和 robots 阻挡混成一个动作。
Shopify robots.txt 文档 (在新标签页打开)核对于
支持什么
用于说明 Shopify 默认 robots.txt 通常足够,误改可能造成流量损失。
Shopify sitemap 文档 (在新标签页打开)核对于
支持什么
用于说明 Shopify 自动生成 sitemap,提交只是帮助发现,不是收录承诺。
Shopify robots.txt.liquid 文档 (在新标签页打开)核对于
支持什么
说明自定义模板会替换生成的 robots.txt 输出,需保存改前文件并比对实际输出。
Shopify URL redirects 文档 (在新标签页打开)核对于
支持什么
用于说明 redirect 需要看失效来源、相关目标、市场路径和缓存边界,不是泛化清理按钮。
Google URL Inspection 帮助 (在新标签页打开)核对于
支持什么
区分索引记录与当前实时测试,说明各自能看到什么。
支持什么
解释索引与排除状态;合理排除不需要全部变成已收录。